INTERSERV AG Zurich:
INTERSERV SA Lausanne:
Sélectionnez votre langue


1971
Fondation
978231+
Projets
2
Lieux
1258+
Traductrices et traducteurs
150%
prêt à l'emploi
A++
Qualité
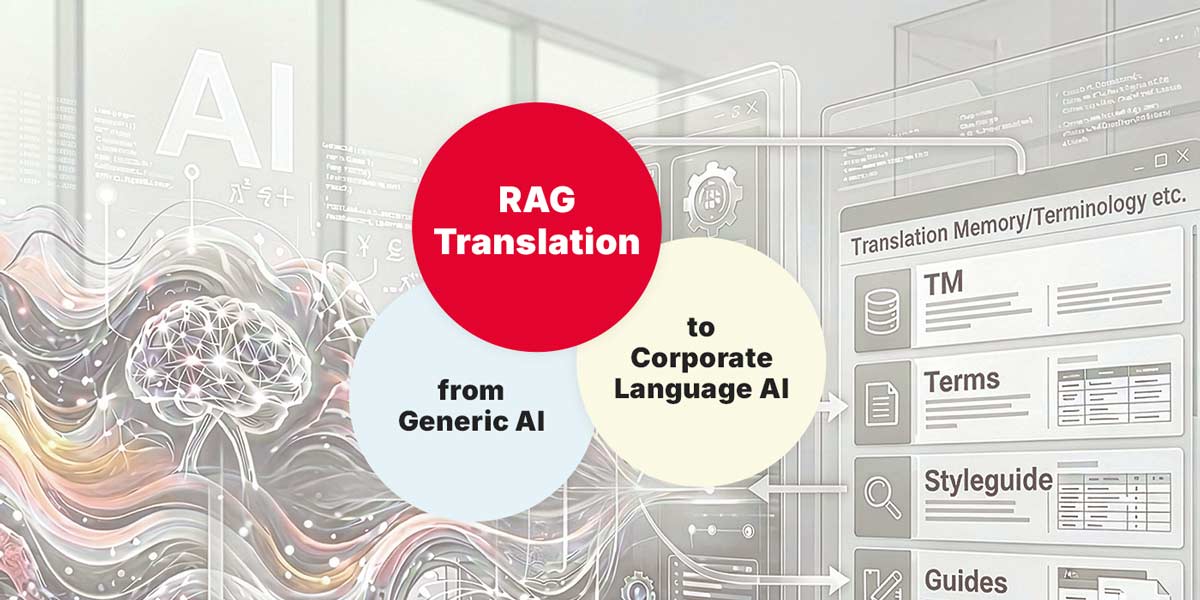
La traduction IA avec RAG allie l’IA générative aux informations spécifiques à chaque entreprise. Les mémoires de traduction, les bases de données terminologiques, les guides de style et les traductions existantes sont utilisés comme sources.
En effet, si un modèle d’IA général maîtrise beaucoup de langues, il ne connaît pas nécessairement les termes, les formulations et les choix de traduction qu’une entreprise a élaborés au fil des années. Avec la génération augmentée par récupération (en anglais Retrieval Augmented Generation, RAG), tous ces éléments sont précisément intégrés dans les traductions.
Une IA générative ou un grand modèle de langage (Large Language Model, LLM) sait traduire des textes. Mais pour produire un résultat véritablement personnalisé, une connaissance générale de la langue ne suffit pas toujours.
En effet, les entreprises ont souvent leur propre langage:
Ces éléments se trouvent généralement dans les mémoires de traduction, les bases de données terminologiques, les glossaires, les guides de style, les traductions existantes ou les publications et documentations.
Mais pour qu’une IA ou un LLM les intègre, ceux-ci doivent avoir été injectés au préalable pour entraîner le système. Et même si certains éléments ont été utilisés à un moment donné comme supports d’entraînement, cela ne signifie pas pour autant que le modèle connaît le langage actuel de votre entreprise, qui a peut-être évolué.
RAG signifie Retrieval Augmented Generation, soit en français « génération augmentée par récupération » ou « génération à enrichissement contextuel ». Il s’agit d’une approche selon laquelle une IA générative puise non seulement dans son modèle de connaissances général, mais également dans des informations ciblées provenant de sources externes afin de les utiliser comme contexte.
Le principe est relativement simple:
Il n’est pas nécessaire d’injecter les données de l’entreprise de manière permanente dans le modèle de langage ni de consacrer du temps à réentraîner le modèle. Les informations pertinentes sont récupérées en fonction des besoins et fournies à titre de contexte.
Les entreprises ne peuvent et ne souhaitent pas injecter définitivement leurs mémoires de traduction et leurs glossaires sensibles dans d’immenses LLM. Outre des coût élevés et des risques pour la protection des données, une telle approche se heurte à l’obsolescence rapide des informations. La RAG apporte une réponse élégante à ce problème en permettant l’intégration modulaire d’éléments actuels sous la forme d’un contexte dynamique, dans le respect de la protection des données.
C’est là que réside toute la valeur ajoutée de la traduction RAG.
L’association d’un système RAG à la traduction IA offre de nombreux atouts:
La génération augmentée par récupération est un processus en trois étapes:
Vous trouverez de plus amples informations techniques dans la documentation d’AWS sur la RAG.
Différentes sources d’information peuvent servir de base pour une traduction IA personnalisée.
Une mémoire de traduction (MT) contient des traductions déjà réalisées et, dans l’idéal, vérifiées. Le système RAG peut récupérer les segments utiles ou les formulations similaires et les indiquer à l’IA comme contexte. Il ne remplace donc pas les fonctions classiques de concordance d’une mémoire de traduction, mais les complète avec une méthode d’enrichissement basée sur l’IA.
La qualité des données reste toutefois déterminante. En effet, si la RAG permet d’accéder aux éléments existants, elle n’est pas nécessairement en mesure d’évaluer leur qualité technique et linguistique. Il faut donc effectuer la distinction entre les traductions récentes et vérifiées et les contenus plus anciens ou moins pertinents.
Une base de données terminologique contient les termes privilégiés et leurs traductions. Cette terminologie est d’autant plus importante lorsqu’il s’agit de textes techniques, médicaux ou juridiques.
Elle donne à l’IA des informations sur le sens d’un terme, mais également sur sa traduction dans le contexte spécifique de l’entreprise. Cela peut jouer un rôle essentiel pour les noms de produits, les désignations techniques ou les termes métier, par exemple.
Un guide de style peut contenir des consignes sur le ton, l’orthographe, les formules de politesse, les noms de produits ou certaines conventions linguistiques. Ces informations peuvent également servir de contexte dans le processus de traduction.
Outre les termes à utiliser, elles permettent ainsi de déterminer la manière dont l’entreprise communique.
Les textes déjà publiés ou vérifiés en interne peuvent également contenir de précieuses informations. Ils indiquent à l’IA comment une entreprise s’exprime réellement, et pas seulement comment elle pourrait s’exprimer selon un modèle de langage général.
Le langage de votre entreprise est ainsi intégré à l’IA.
La différence fondamentale entre l’IA et l’IA avec RAG peut se résumer de la manière suivante:
|
IA générative |
IA générative avec RAG |
|
|
Connaissances linguistiques |
Modèle de connaissances général |
Modèle de connaissances général + contexte de l’entreprise |
|
Terminologie |
Connaissances techniques/linguistiques générales |
+ Terminologie propre à l’entreprise |
|
Traductions antérieures |
Pas nécessairement disponibles |
Possibilité de récupérer les contenus utiles dans les mémoires de traduction |
|
Style de l’entreprise |
Pas nécessairement connu |
Possibilité d’intégrer le guide de style et les textes existants |
|
Exemple |
Comment pourrait-on traduire ce terme? |
Comment cette entreprise utilise-t-elle ce terme? |
Il s’agit d’un changement de perspective majeur: l’IA n’a pas besoin de connaître «par cœur» toutes les informations propres à l’entreprise. Elle reçoit uniquement les éléments dont elle a besoin pour effectuer la tâche de traduction concernée.
La RAG jette ainsi un pont entre l’IA générative générale et le langage spécifique à chaque entreprise.
|
Approche |
Base |
Informations de l’entreprise |
Principaux avantages |
|
Traduction automatique classique |
Modèle de traduction entraîné |
En partie via d’autres systèmes |
Rapidité |
|
IA générative |
LLM |
Modèle de connaissances général |
Contexte, flexibilité |
|
IA générative + RAG |
LLM + sources externes |
Récupération ciblée |
Contexte de l’entreprise |
|
RAG + TM + terminologie + post-édition |
LLM + ressources de l’entreprise + révision spécialisée |
Complètes |
Qualité + cohérence + contrôle |
Lorsqu’une entreprise fait appel à des processus de traduction professionnels depuis plusieurs années, il existe souvent de vastes ressources linguistiques, telles qu’une mémoire de traduction ou une base de données terminologique. La RAG permet d’associer plus étroitement ces éléments existants à l’IA générative.
Les mémoires de traduction, les bases de données terminologiques ou les outils de TAO classiques n’en deviennent pas superflus pour autant. Bien au contraire: leurs contenus peuvent constituer des sources d’information importantes pour les processus de traduction assistés par l’IA.
La RAG n’est donc pas une simple déclinaison de la traduction automatique. Tout son intérêt réside dans le fait qu’elle associe un modèle d’IA générative aux ressources propres à l’entreprise.
Ce type d’architecture est surtout intéressant pour les entreprises qui traduisent d’importants volumes de contenus récurrents ou spécialisés.
Par exemple:
Plus les ressources linguistiques existantes sont vastes et cohérentes, plus elles contiennent d’informations utiles pour les nouvelles traductions.
Aussi alléchante que soit la promesse, la RAG ne constitue pas à elle seule une garantie de qualité. La performance d’une architecture RAG dépend entièrement de la précision de sa recherche et de la base d’informations sur laquelle elle s’appuie.
Si le système trouve des informations fausses, néglige des éléments importants ou considère des traductions obsolètes comme pertinentes, l’IA générative associée peut également produire un résultat erroné.
Les aspects suivants jouent notamment un rôle déterminant:
À cela s’ajoutent, pour les données internes d’une entreprise, les exigences de sécurité et de protection des données. Le plan technique et organisationnel doit déterminer quelles données peuvent être utilisées pour un système RAG et où celles-ci seront traitées.
La RAG ne remplace donc pas un processus de traduction professionnel. Il s’agit plutôt d’une architecture qui permet d’intégrer plus précisément les informations existantes dans une technologie d’IA.
Ce n’est pas nécessairement en opposant l’IA et l’humain que l’on obtient la meilleure traduction personnalisée. En effet, chacune des parties peut réaliser des tâches différentes.
L’IA sait traiter d’importants volumes d’informations, récupérer des contenus utiles dans les ressources de l’entreprise et générer rapidement une proposition de traduction.
Lors de la phase de post-édition, les traductrices, traducteurs, relectrices et relecteurs s’assurent ensuite que la terminologie, le contexte, la technicité, le style et le mode d’expression sont conformes aux attentes.
Ce mécanisme crée une boucle de rétroaction particulièrement intéressante. En effet, les traductions vérifiées peuvent ensuite être intégrées dans la mémoire et la base de données terminologique, ce qui améliore le socle des traductions à venir.
Un processus continu d’apprentissage et d’assurance qualité peut ainsi naître d’une opération de traduction ponctuelle, sans qu’il soit nécessaire de réentraîner constamment le modèle génératif en lui-même.
Traduction IA avec post-édition
Le développement de la traduction IA prend ainsi une nouvelle direction.
La RAG propose ainsi une approche intéressante, dans la mesure où la ressource essentielle n’est pas le modèle de langage en lui-même, mais son association avec les éléments internes de l’entreprise.
Pour obtenir une traduction IA personnalisée grâce à la génération augmentée par récupération, il n’est pas nécessaire d’entraîner un modèle de langage spécifique pour chaque entreprise. La RAG récupère les informations internes qui lui sont utiles en fonction des besoins et les fournit à l’IA générative comme contexte.
Les mémoires de traduction, les bases de données terminologiques, les guides de style et les traductions existantes deviennent ainsi des éléments clés d’une architecture de traduction assistée par l’IA. La RAG revêt un intérêt particulier pour les entreprises qui disposent déjà de ressources linguistiques riches et de qualité. C’est le cas de celles qui travaillent avec un prestataire de traduction professionnel, par exemple. Ces processus impliquent souvent la création de mémoires de traduction et de bases de données terminologiques propres à chaque client, qui peuvent ensuite constituer des sources précieuses pour les traductions IA.
À l’avenir, la question centrale ne sera donc plus: quel modèle d’IA fournit les meilleures traductions? Mais: quelle IA sait tirer le meilleur parti des informations propres à mon entreprise?
Obtenir des conseils: traduction IA avec RAG
La RAG (Retrieval Augmented Generation, soit en français « génération augmentée par récupération » ou « génération à enrichissement contextuel ») est une approche consistant à fournir à une IA générative des informations pertinentes de manière ciblée. L’IA utilise ensuite ces informations pour réaliser sa traduction. La traduction IA ainsi optimisée intègre le contexte et le langage propres à votre entreprise.
Une traduction RAG accorde une importance particulière aux informations et au ton spécifiques à l’entreprise. Il n’est pas nécessaire d’indiquer à la main les références et les sources utiles. La traduction RAG présente ainsi un avantage par rapport à une traduction IA classique et fournit un résultat plus adapté au contexte.
Non. Si la RAG permet d’adapter les traductions IA au client, elle repose sur les décisions statistiques d’une machine et ne garantit donc pas une plausibilité ni une pertinence humaines. Pour les textes exigeants du point de vue de la langue, du contenu ou de la technicité, un contrôle par des traductrices et traducteurs de langue maternelle est ensuite recommandé.
La RAG en elle-même n’offre aucune garantie de confidentialité: cet aspect dépend de l’architecture et du système utilisé. L’endroit où les données de l’entreprise sont enregistrées et traitées joue un rôle décisif. Notre architecture nous permet d’indiquer à l’IA les informations propres à l’entreprise comme contexte pour les traductions, sans les intégrer dans l’entraînement du modèle.
Selon la solution choisie, les données de votre entreprise peuvent être enregistrées, par exemple, dans une base de connaissances séparée et récupérées en cas de besoin pour servir de contexte lors d’une traduction. Vos données ne sont pas automatiquement utilisées pour entraîner le modèle d’IA. Nos règles de confidentialité, de protection des données et de sécurité de l’information couvrent ces scénarios et font régulièrement l’objet d’un audit externe dans le cadre de la certification ISO.

Demander un devis pour des prestations de traduction ne se résume pas à ach ...

Congrès international professionnel, conférence en plusieurs ...

L’IA transforme-t-elle seulement les processus, ou redéfinit-elle aussi le ...

Faites traduire votre site web en plusieurs langues directement à partir du CMS a ...

Un seul mot est capable de mettre un contrat entier sens dessus desso ...

Le rapport annuel est la vitrine d’une entreprise ou d’une organisation. ...

Douze mois, une multitude de mots et au moins un onglet de navigateur en trop: 2025 a été bien remplie. Entre rapports a ...

À partir du 1er décembre, vous pourrez ouvrir chaque jour une nouvelle fenêtre sur notre ...

Rapide, cohérente et économique, tout en offrant un résultat précis, élégant et conforme à l’identit ...

Avec une traduction certifiée ISO, vous avez la garantie que vos textes seront non seulement traduits avec exacti ...

L’IA génère des contenus en quelques secondes, et les dictionnaires et les outils de ...

Comment les contenus multilingues augmentent la visibilité – et l’IA modifie ...

Nos rédacteurs passent votre texte ou votre traduction au peigne fin: grammai ...

Traduction urgente: des textes précis et professionnels, livrés en quelques heures
...
Traduction professionnelle de vos fichiers de PAO sous InDesign avec une mise en page de qualité, po ...

Traduction professionnelle de vos présentations et diapositives PPT pour des textes précis avec un ren ...

Touchez un public international avec le sous-titrage, la voix off, la transcription ou la tradu ...

Véritables copilotes des traductrices et traducteurs, les outils de TAO assurent des trad ...

En confiant la traduction de votre newsletter à un service professionnel, vous vous rapprochez de votr ...

C’est avec un immense plaisir que nous accueillons dans nos locaux les œuvres de l’artist ...

En tant que société de traduction, nous savons combien il est important d’utiliser les bon ...

Pour pouvoir vous servir au mieux durant toute la période de l’Avent, nous avo ...

En plus de votre mémoire de traduction, INTERSERV gère aussi votre propre glossaire. Avec TermS ...

Mémoire de traduction et base de données terminologique: des outils qui révolutionnen ...

Vernissage avec cocktail dînatoire. Exposition des œuvres de l’artiste tessinoise Veron ...